围绕「让 AI 助手理解整个代码库」这件事,2026 年陆续出现了几条不同的技术路线。Graphify 把图存成 JSON 文件,靠 LLM 在文件上查询;GitNexus 用 WebAssembly 把图数据库塞进浏览器;而 CodeGraphContext(简称 CGC)走的是另一条更"工程化"的路:把代码库的结构索引到一个真正的图数据库里——KuzuDB、Neo4j、LadybugDB、FalkorDB 都行——然后通过 MCP 协议把 Cypher 查询能力开放给 AI 助手。
3.4k stars 在这个领域不算最显眼的数字,但 CGC 是被 Claude、Cursor、Windsurf、Gemini CLI、Codex、Amazon Q Developer 等多个主流 AI 工具同时收录的少数 MCP 服务器之一。它的 CLI 也独立可用——即使你不用 AI 助手,也能直接在终端跑「找出所有调用 get_user_by_id 的函数」这种问题。本文拆解它的设计与 MCP 集成方式。

为什么用真正的图数据库
Graphify 把图存成内存中的 NetworkX 结构 + JSON dump,胜在轻量;CGC 反其道而行之——它认为代码库的结构性查询本来就是图数据库的天然主场,应该用专业工具,而不是在 JSON 上自己造轮子。
具体的好处是几方面的:
Cypher 查询语言原生支持。Neo4j 系的 Cypher 是图查询事实标准,写「找出从 A 函数出发深度不超过 3 的所有调用」这种问题用 Cypher 几行搞定。如果用 JSON 自己 traverse 要写一堆遍历逻辑,性能也成问题。
实时文件监听。CGC 内置 watcher,文件变了图自动增量更新——不需要等 git commit。这对开发过程中的 AI 辅助很关键,AI 看到的代码图永远和当前 working tree 一致。
多个图数据库后端:
- KuzuDB(默认,所有平台)— 嵌入式图数据库,零配置启动
- LadybugDB — 同样嵌入式,体积更小
- FalkorDB Lite — Unix 系统专用,性能优化
- FalkorDB Remote / Neo4j / Nornic DB — Docker 部署,企业级
这种"开发用嵌入式、生产用远程"的分层非常实用。本地试用直接 pip install 跑 KuzuDB 嵌入式;团队规模上来要 Neo4j 集群也只需要改一行配置。
安装与首次索引
最快的上手路径就一行 pip:
pip install codegraphcontext
然后选一个仓库做首次索引:
cd ~/projects/dranixj
cgc index .
cgc index 会做几件事:扫描所有源文件(默认按 .gitignore 过滤),用对应语言的 Tree-sitter 解析器抽取符号节点(函数、类、方法、参数、import),构建调用、继承、引用三类边,最后写入图数据库(默认 KuzuDB,存到 ~/.cgc/db/)。
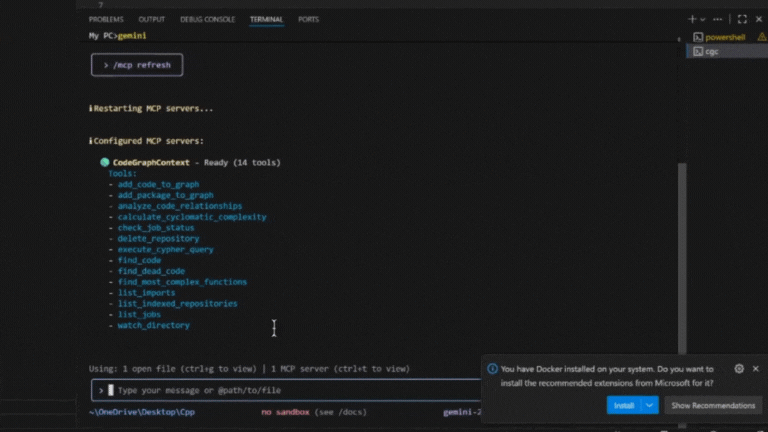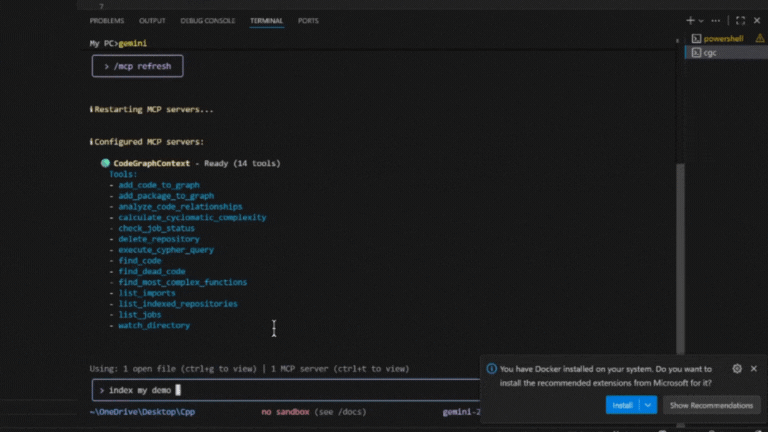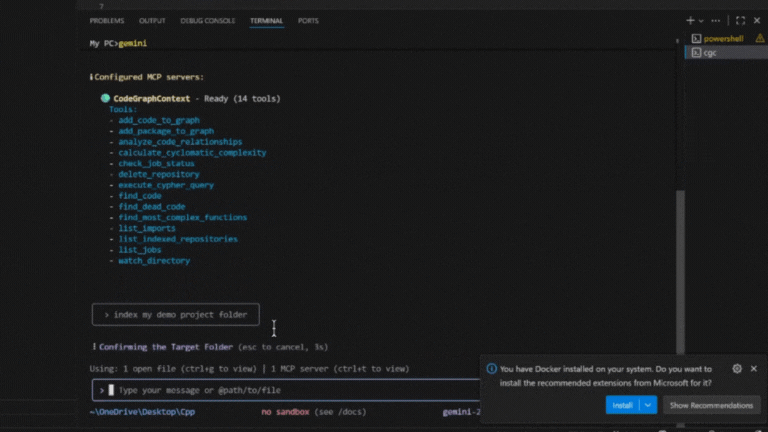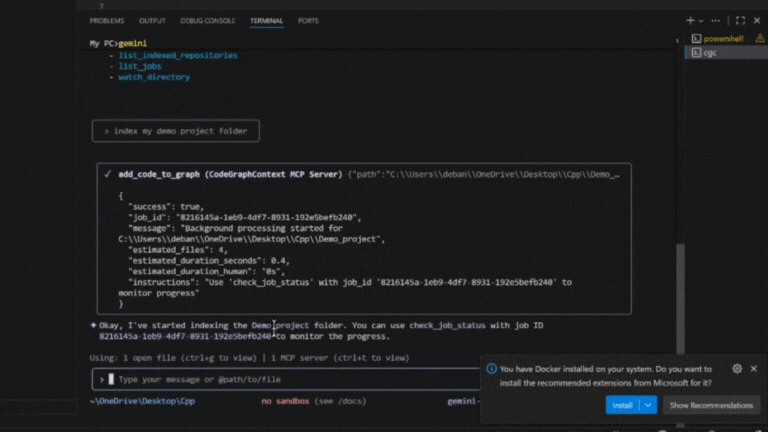
20 种语言全部支持:Python、JavaScript、TypeScript、Java、C/C++、C#、Go、Rust、Ruby、PHP、Swift、Kotlin、Dart、Perl、Lua、Scala、Haskell、Elixir、TSX。中等规模的仓库(5–10 万行)首次索引大约 30 秒–2 分钟,之后增量更新是毫秒级。
CGC 还提供"预构建仓库包"(pre-indexed bundles),常用开源项目(React、Django、Linux kernel 等)官方已经索引好,下载一个压缩包导入即可,省得自己花几小时跑首索引。
CLI:终端里的代码导航器
CGC 最酷的特性之一是 CLI 完全独立可用——不需要 AI 助手也能跑。常用命令:
# 列出所有调用 get_user_by_id 的函数
cgc find callers get_user_by_id

# 找出 main 函数的完整调用链(深度 3 层)
cgc find call-chain main --depth 3

# 复杂度分析:列出当前仓库圈复杂度 top 20 的函数
cgc analyze complexity --top 20

# 死代码检测:未被任何路径调用的函数
cgc analyze dead-code

# 启动 watcher,文件变动时图自动更新
cgc watch
对于做 code review 或者重构的场景,这套 CLI 比传统的 grep + 手工建模快很多。你不需要在脑子里维护一张调用图——直接问图数据库就行了。
MCP 服务器:AI 助手的代码导航插件
CGC 真正的杀手 feature 是它的 MCP 服务器模式。Model Context Protocol(MCP)是 Anthropic 主导推动的开放协议,让 AI 助手能动态加载外部工具。把 CGC 装成 MCP 服务器后,Claude / Cursor 等可以直接调用图查询能力。
注册到 Claude Code:
cgc mcp install --client claude-code
它会自动写入 ~/.config/claude-code/mcp.json(或你的 OS 对应的配置位置),下次启动 Claude Code 时 CGC 的 16 个工具就可用了。最常用的几个:
query— 自然语言或 Cypher 查询callers <symbol>— 找出调用某符号的所有位置callees <symbol>— 找出某符号调用的其他函数call_chain <from> <to>— 找出从 A 到 B 的所有调用路径impact <symbol>— 改这个符号会影响哪些下游complexity <file>— 计算文件 / 函数复杂度dead_code— 查死代码
实战体验上,最有价值的是 AI 跨文件提问的准确率提升。以前你问 Claude「如果我把 formatDate 的签名改了,要改哪些调用方?」它会 grep 一圈,可能漏掉用了别名 import 或者动态调用的位置;现在它通过 callers formatDate 直接拿到图数据库的确定性结果。
与其他「代码图」方案对比
把 CGC 放在同期项目里横向比一下:
| 项目 | 形态 | 存储 | 集成方式 | 最大优势 |
|---|---|---|---|---|
| CodeGraphContext | CLI + MCP server | KuzuDB / Neo4j 等 | MCP 协议 | 真正的图数据库,Cypher 查询,可独立 CLI 使用 |
| Graphify | AI 助手 Skill | JSON 文件 | Skill / Slash command | 多模态(代码+文档+图片),跨 AI 平台一致体验 |
| GitNexus | 浏览器 SPA | KuzuDB WASM | 上传 ZIP / Git URL | 零服务器,代码不离开浏览器 |
| Understand-Anything | Claude Code 插件 | 自定义结构 | Plugin | 多 Agent 流水线,专为 Claude Code 优化 |
四个项目目标相似(让 AI 看懂代码库)但落地哲学完全不同。如果你团队里已经有 Neo4j 或者计划部署专业图数据库,CGC 是最自然的选择;如果只是个人项目想轻量试用,Graphify 更省事;如果担心代码隐私,GitNexus 的浏览器端方案最稳妥。
实际取舍:什么时候选 CGC
我自己梳理下来,选 CGC 主要考虑这几个场景:
- 企业级代码库,几十万到几百万行。Graphify 的 JSON 方案在这个规模下会撑不住,CGC 的图数据库才有规模化的查询性能。
- 要多 AI 助手共享同一份索引。MCP 协议让你 index 一次,Claude / Cursor / Codex 都能用。
- 既要 AI 集成又要独立 CLI。比如 CI 里跑 dead-code 检测、code review 阶段查 impact,都用 CGC 同一个工具链。
- 需要复杂图查询。比如「找出所有把用户输入直接传给数据库查询的代码路径」(安全审计场景)——这种 Cypher 一行搞定的事,JSON 方案得自己写遍历。
不太适合的场景:
- 多模态需求强(要同时索引代码 + PDF + 图片)— Graphify 这块更全面。
- 零服务器零安装诉求 — GitNexus 是更合适的选择。
- 超小项目 — 500 行的项目用 grep 就够了,杀鸡用牛刀。
总结
「让 AI 助手获得代码库结构性视图」是 2026 年 AI 编程工具最重要的方向之一,而 CGC 在这个方向里代表了「老老实实用专业图数据库 + 标准 MCP 协议」的工程化路线。它没有 Graphify 那种"病毒式增长"的传播效果,但在中大型项目里的扎实程度和可扩展性,是少数几个能真正进生产环境的同类方案。
如果你已经在用 Claude Code 或 Cursor,并且代码库规模上来后越来越觉得 AI 回答跨文件问题不靠谱,把 CGC 装上试试——它的安装-到-第一个查询返回的整个 onboarding 时间不会超过 10 分钟。
评论