向量数据库(vector DB)在过去两年几乎成为 AI Agent 记忆系统的事实标准——把对话和事实切成 chunk,embed 之后丢进 Chroma 或 Qdrant,靠余弦相似度做召回。但当你真的把这套方案推到生产环境,问题就一个接一个浮现:召回的内容为什么不准?这条「错误的偏好」是什么时候写进去的?切到一个新分支去做实验时,主线的记忆会不会被污染?
Memoir 是 2026 年最近受到大量关注的一个开源项目,它用一种非常「程序员风格」的思路重新设计了 AI Agent 的记忆层:把 Git 的版本控制模型搬过来。每次记忆变更都是一个 commit,支持分支(branch)、合并(merge)、回滚(rollback)和 memoir blame——就像你 review 代码一样 review Agent 学到的东西。项目以 Apache 2.0 协议开源,提供 Python SDK、CLI、Web UI 以及 Claude Code 与 Codex 的官方插件。本文拆解它的核心设计,并演示如何在 Claude Code 里把它装进日常工作流。

为什么 Git 模型适合做 Agent 记忆
要理解 Memoir 的设计,先要看清向量数据库做 Agent 记忆时遇到的几个具体痛点。
召回不可解释。当 Agent 用了一条「错误的偏好」(比如把已经废弃的 API 风格当成你的偏好继续用),你很难追溯它是从哪条对话学到的。向量相似度只告诉你「这条记忆和当前查询很像」,不告诉你它来自哪里、是谁写的、什么时候写的。
没有上下文隔离。当 Agent 同时服务多个项目或多个分支,记忆是混在一个向量空间里的。在 React 项目里学到的 hook 用法可能被错误召回到 Vue 项目,跨上下文污染(context contamination)成了一个普遍但难解的问题。
改动不可逆。给 Agent 注入一条「实验性」记忆——比如尝试一个新的代码风格——之后想撤销,向量数据库没有原生的回滚概念。你只能用元数据打 tag,或者把整个数据集重做。
Memoir 给出的答案,是把 AI 记忆当成代码仓库来管理。每条记忆有一个语义路径(taxonomy path),比如 preferences.coding.style 或 profile.professional.skills.python;这就像文件系统里的目录结构,O(log n) 时间内可以直接定位,不需要做向量搜索。每次写入是一次 commit,附带 SHA-256 校验和、作者、时间戳和 commit message。需要切换上下文时,开一个新 branch,记忆世界自动跟随 Git 分支切换——就像 git checkout 既切代码也切环境。
核心架构:Prolly Tree + 内容寻址
Memoir 的底层并不直接调用 Git 二进制,而是实现了一个面向语义路径的 Prolly Tree(Probabilistic Merkle Tree)存储。Prolly Tree 把 Merkle 树和 B 树结合起来:节点的分裂点由内容的哈希决定,相同的内容总会生成相同的子树结构。这带来两个直接好处:
第一,结构共享(structural sharing)。两个分支共享 90% 内容时,存储几乎只占一份——这点和 Git 的 packfile 思路一致,但更细粒度。第二,内容寻址(content-addressed)。每个节点都有一个由内容计算出的 SHA-256,任意篡改都会破坏链路,整个历史天然防篡改。
在这之上,Memoir 把记忆按层级路径组织。比如要存「Sarah 偏好 2 空格缩进 + tab 字符」,会写到 preferences.coding.style。查询时既可以走精确路径(瞬时返回),也可以走 LLM 驱动的语义路径——后者由内置的 IntelligentClassifier 把自然语言查询映射到最相关的若干路径。
这种设计的一个直接收益是:召回结果是可解释的。当 Memoir 返回一条记忆时,它会告诉你这条记忆在哪个路径、由哪个 commit 写入、属于哪个 branch;用 memoir blame preferences.coding.style 可以看到这条偏好的完整修改历史,就像 git blame 一样。
Claude Code 插件实战
Memoir 提供了 Claude Code 的原生插件,安装只需要两条命令:
/plugin marketplace add zhangfengcdt/memoir
/plugin install memoir@memoir
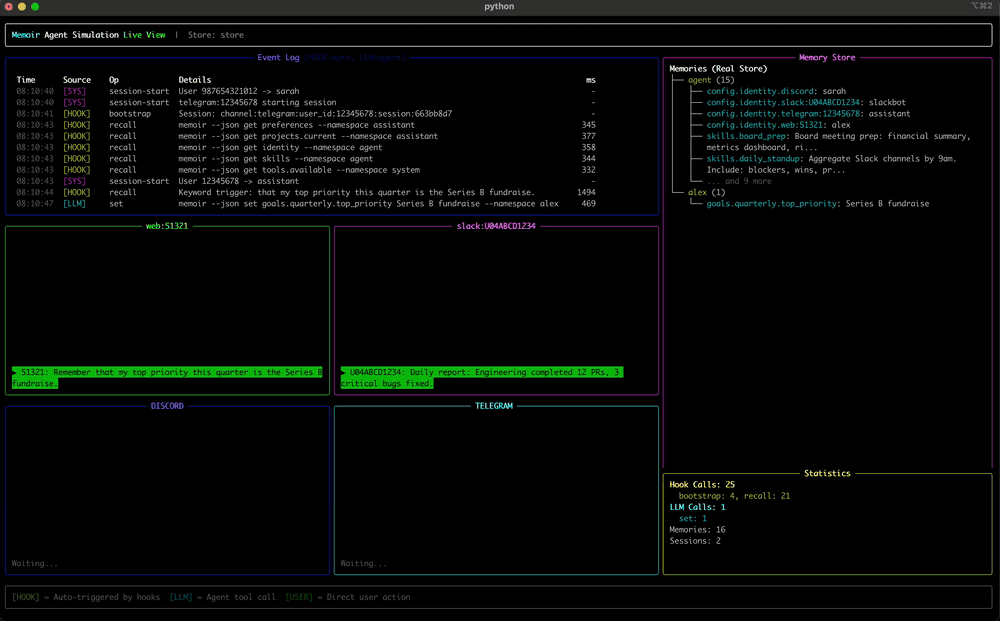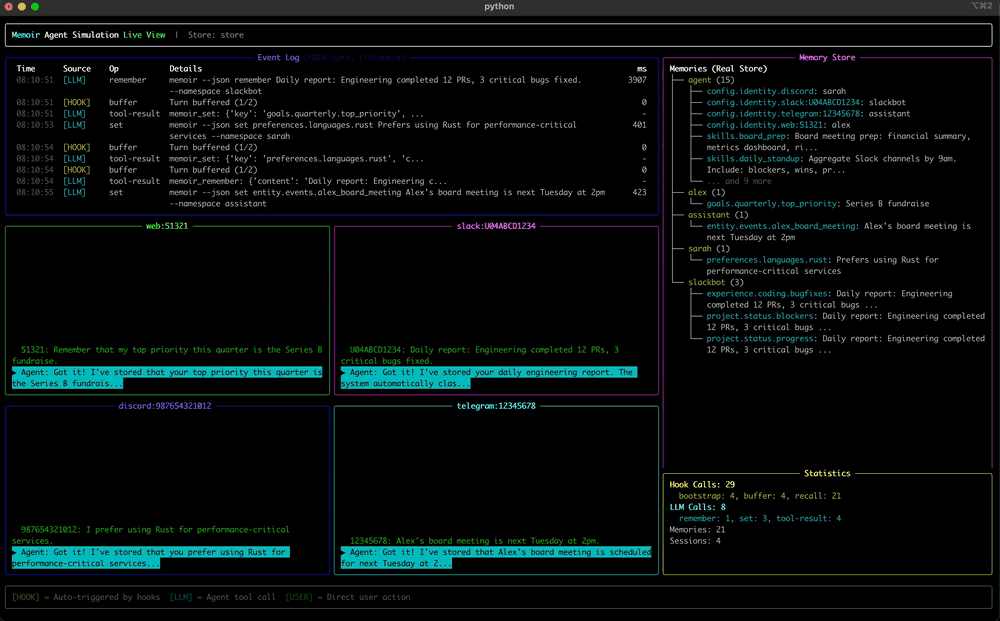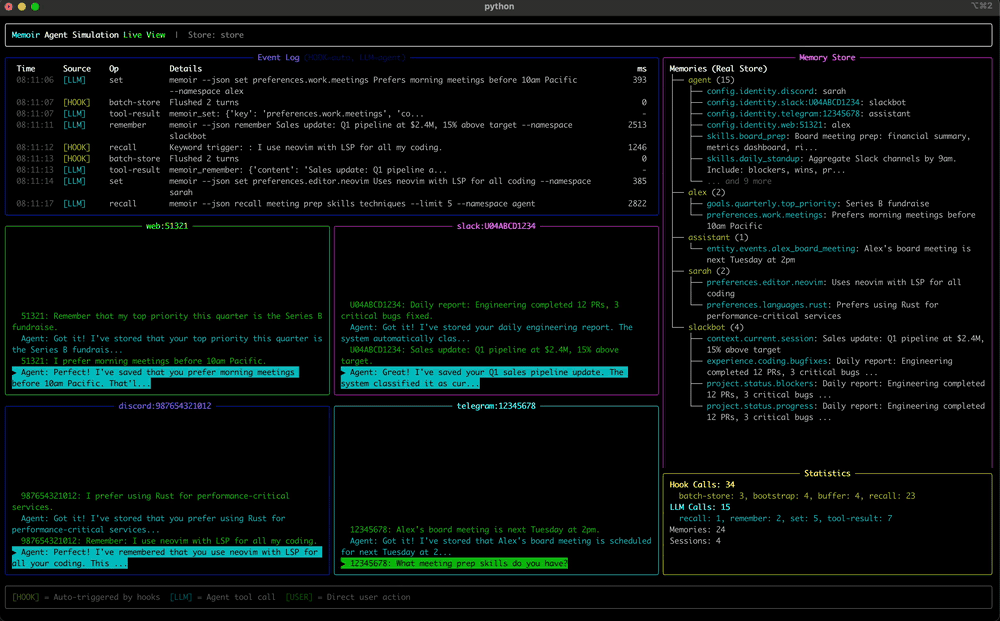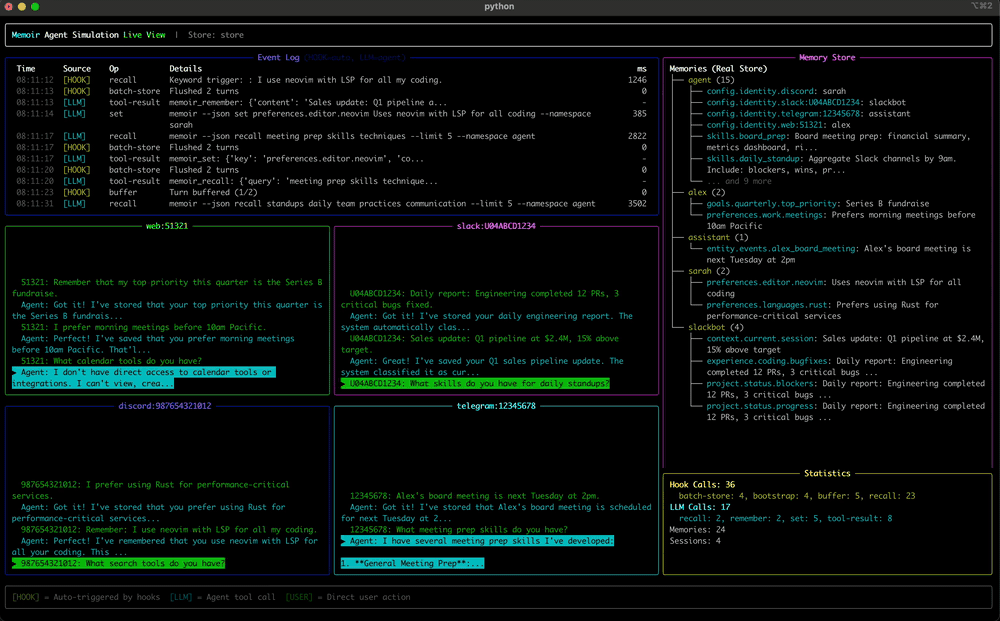
插件装好之后,Claude Code 会在会话开始时自动注入相关记忆作为上下文,在会话结束时自动调用 memoir remember 把新学到的偏好/事实持久化。整个过程对用户透明,但你可以随时用 slash command 介入:
/memoir-remember <内容>— 主动写入一条记忆/memoir-recall <查询>— 显式召回相关记忆/memoir-ui— 启动 Web UI 浏览整个记忆树
实际使用中最让人惊喜的是 branch awareness。当你在 feat/auth-refactor 分支上工作,Memoir 会自动切换到对应的记忆分支,所有写入只影响这个分支;切回 main,刚才那些实验性偏好就消失了。Merge 回主线时,你可以像 review PR 一样审视哪些记忆要保留、哪些要丢弃。
Memoir 也提供 CLI 直接管理记忆库,不绑定特定 Agent:
memoir new my-store
cd my-store
memoir remember "Sarah 偏好 2 空格缩进 + tab 字符" -p preferences.coding.style
memoir get preferences.coding.style
memoir recall "Sarah 喜欢什么缩进风格?"
memoir blame preferences.coding.style   # 查看修改历史
memoir ui                                # 启动 Web UI
对于多 Agent 协作场景(比如同时跑两个并发的 sub-agent),Memoir 的 branch 模型也能很自然地处理:每个 sub-agent 在自己的分支上写入,主 Agent 决定合并策略,冲突可以走标准的 Git merge 流程。
和向量数据库类方案的对比
把 Memoir 放在和 Mem0、Supermemory、Letta Context Repositories 等同期项目的横向对比里,几个差异就比较清晰了:
| 维度 | 向量 DB 方案(Mem0 等) | Memoir |
|---|---|---|
| 召回方式 | 余弦相似度 | 语义路径 + LLM 路径推断 |
| 召回耗时 | 毫秒级,但需要向量索引 | O(log n) 路径查找 |
| 可审计性 | 元数据需自己加 | 原生 commit + blame |
| 分支隔离 | 自定义 namespace | Git 原生 branch |
| 回滚 | 全量 dump/restore | memoir checkout <commit> |
| 跨设备同步 | 依赖向量 DB 后端 | 像 Git 仓库一样 push/pull |
向量方案在「模糊查询大量非结构化文本」上仍然有优势——比如让 Agent 在十万条客服对话里找相似案例,向量召回快很多。Memoir 更适合「需要明确归属和可解释性」的场景:开发者的代码偏好、项目专属规则、长期人设记忆、合规审计要求。
Memoir 的作者在文档里特别强调,他们并不想取代向量数据库——你完全可以把 Memoir 用于结构化的偏好/规则记忆,同时保留向量 DB 来做大规模事实召回。两者解决的是不同的问题。
何时该用、何时别用
Memoir 适合以下场景:
- 编码 Agent 的长期偏好管理。比如 Claude Code、Codex 这类长期跟随你的 Agent,记住你的代码风格、命名约定、技术栈偏好。
- 多项目/多分支隔离。你需要 Agent 在不同代码仓库或分支间保持不同的记忆视图。
- 可审计的 AI 系统。合规要求 Agent 学到的每一条规则都要可追溯。
- 小型团队共享记忆。把 memoir 仓库当成普通 Git repo push 到 GitLab/GitHub,团队成员共享同一套 Agent 配置。
不适合的场景:
- 海量非结构化文档检索。这是向量方案的主场。
- 超低延迟要求。LLM 驱动的智能分类有 LLM 调用开销,对延迟敏感的应用要做好缓存。
- 不愿意接受目录式建模。如果你的记忆本质上是扁平的、关系混乱的,强行套语义路径会很别扭。
总结
Memoir 的核心洞察很简单:程序员管理代码已经用了 20 年 Git,没必要重新发明记忆管理的方法论。把 commit、branch、blame、merge 这些被验证过的原语搬到 AI 记忆层,不仅解决了向量数据库难以审计的痛点,还顺带带来了多设备同步、团队协作、分支实验等一系列副作用收益。
如果你正在被 Agent 的「记忆漂移」问题困扰——它今天记住的偏好和昨天不一样,召回不准还查不出原因——值得花一两个小时把 Memoir 装进 Claude Code 试试。它不能解决所有问题,但能把「Agent 学到的东西」这件事从黑盒变成白盒,光这点对长期协作就很有价值。
评论